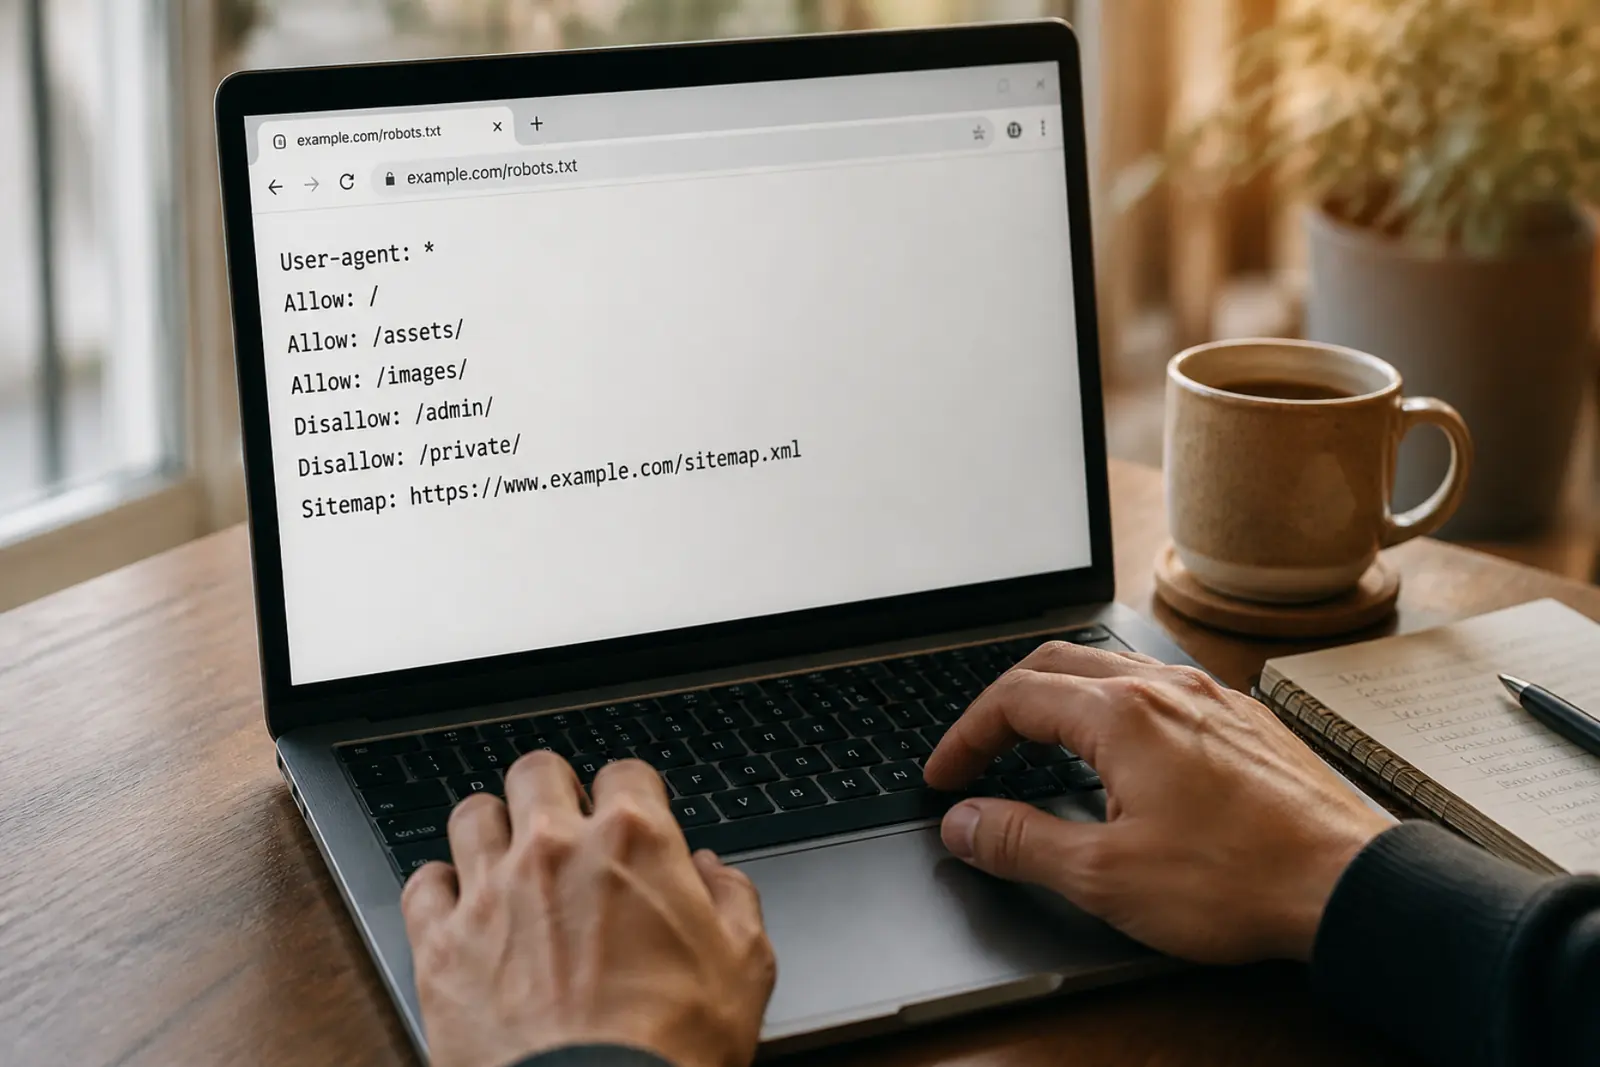
Zeptali jste se ChatGPT na svůj obor a město a odpověď vyjmenovala tři konkurenty, vás ne. První reakce bývá napsat víc článků. Jenže když se robot OpenAI k vašim stránkám nedostane, nebo dostane prázdnou kostru bez textu, žádný nový článek to nespraví. Technickou dostupnost proto při AI auditu webu řešíme dřív než obsah, protože bez ní nemá smysl zkoumat, co o vás AI říká.
Rozhodují o tom tři místa. Soubor robots.txt, kde říkáte, kdo smí dovnitř. Hosting nebo CDN, které můžou robota odmítnout, i když robots.txt mlčí. A HTML stránky, ve kterém text buď je, nebo ho dokreslí až JavaScript v prohlížeči. Projdeme je v tomhle pořadí.
Vidí ChatGPT váš web, nebo ne?
ChatGPT váš web vidí, jen když platí tři podmínky zároveň. Robot OAI-SearchBot, podle kterého OpenAI vybírá weby do vyhledávání v ChatGPT, nesmí mít zákaz v souboru robots.txt. Hosting nebo CDN ho nesmí odmítnout dřív, než se k robots.txt vůbec dostane. A text stránky musí být v HTML, které posílá server, protože roboti OpenAI podle měření Vercelu JavaScript nespouštějí. Stačí, aby selhala jedna z těch tří věcí, a ve vyhledávání ChatGPT se neobjevíte, ať píšete sebelíp. Opačně to neplatí. Splněné podmínky vám místo v odpovědi nezaručí, jen vás pustí do hry.
OpenAI to píše bez obalu: weby, které OAI-SearchBot zakážou, se v odpovědích vyhledávání ChatGPT nezobrazí, nanejvýš jako navigační odkaz. Co rozhoduje o tom, koho ChatGPT z dostupných webů nakonec doporučí, rozebíráme v článku Jak se dostat do odpovědí ChatGPT. Tady zůstaneme u prvního kroku, bez kterého zbytek nefunguje.
Jaké AI crawlery chodí na váš web a co který dělá?
Na běžný firemní web chodí tři druhy AI robotů a každý chce něco jiného. Trénovací roboti, GPTBot od OpenAI a ClaudeBot od Anthropicu, sbírají texty, ze kterých se můžou učit budoucí modely. Vyhledávací roboti, OAI-SearchBot, Claude-SearchBot a PerplexityBot, si stránky procházejí, aby je AI mohla najít a odkázat na ně v odpovědi. Uživatelští roboti, ChatGPT-User, Claude-User a Perplexity-User, přijdou jen tehdy, když konkrétní člověk v chatu chce informaci z webu. Google je výjimka. Jeho AI přehledy čtou web přes běžný Googlebot a Google-Extended je jen přepínač v robots.txt, žádný samostatný robot.
| Robot (user-agent) | Firma | K čemu slouží | Co udělá zákaz v robots.txt |
|---|---|---|---|
| GPTBot | OpenAI | sběr obsahu pro trénování modelů | obsah se nemá použít k trénování; vyhledávání v ChatGPT neovlivní |
| OAI-SearchBot | OpenAI | výběr webů pro vyhledávání v ChatGPT | web se v odpovědích vyhledávání ChatGPT nezobrazí |
| ChatGPT-User | OpenAI | návštěva stránky, když o ni požádá uživatel ChatGPT | podle OpenAI se na něj pravidla robots.txt vztahovat nemusí |
| ClaudeBot | Anthropic | sběr obsahu pro trénování modelů | budoucí obsah se vyřadí z trénovacích dat |
| Claude-SearchBot | Anthropic | indexace pro vyhledávání v Claude | web se neindexuje pro vyhledávání, klesne viditelnost |
| Claude-User | Anthropic | načtení stránky na dotaz uživatele Clauda | Claude stránku pro uživatele nenačte |
| PerplexityBot | Perplexity | zobrazení a odkazy ve výsledcích Perplexity, ne trénování | web se ve výsledcích Perplexity neukáže |
| Perplexity-User | Perplexity | návštěva stránky na dotaz uživatele | podle Perplexity robots.txt obvykle ignoruje |
| Google-Extended | jen token v robots.txt, vlastní návštěvy nemá; trénování a grounding Gemini | Gemini obsah nepoužije; pozice ani zařazení v Google Search se nemění |
Podle oficiálních stránek OpenAI, Anthropicu, Perplexity a Google Search Central, ověřeno v říjnu 2026.
Z tabulky plynou dvě věci, které české návody často přecházejí. Zaprvé, každé nastavení u OpenAI platí samostatně. Zákaz GPTBota vás z vyhledávání v ChatGPT nevyřadí a povolení OAI-SearchBota neznamená souhlas s trénováním.
Zadruhé, uživatelské roboty robots.txt spolehlivě nezastaví. OpenAI u ChatGPT-User píše, že jde o akce spuštěné člověkem, a proto se na ně pravidla robots.txt vztahovat nemusí. Perplexity u svého Perplexity-User říká totéž ještě přímočařeji. Anthropic naopak uvádí, že všichni jeho roboti robots.txt respektují. Kdo chce mít web před AI opravdu zavřený, musí to řešit na úrovni hostingu, ne jen textovým souborem. Ten je podle samotného standardu RFC 9309 prosba, ne zámek.
Jak povolit ChatGPT v robots.txt?
Pokud váš robots.txt žádného AI robota nejmenuje a skupina User-agent: * nic nezakazuje, ChatGPT povolený už máte a přidávat nemusíte nic. Výslovně ho povolíte dvěma řádky, User-agent: OAI-SearchBot a pod ním Allow: /. Pozor na jedno pravidlo standardu. Robot, který má v souboru vlastní skupinu, se řídí jen jí a pravidla pod hvězdičkou pro něj přestanou platit. OpenAI uvádí, že jeho systémy na změnu v robots.txt reagují zhruba do 24 hodin, Perplexity píše o nejvýš 24 hodinách. Soubor musí ležet v kořeni domény, na adrese vasweb.cz/robots.txt, jinde ho žádný robot hledat nebude.
| Co chcete | Co do robots.txt napsat | Co tím získáte a co ztratíte |
|---|---|---|
| Být ve vyhledávání AI i v trénovacích datech | nic navíc, pokud User-agent: * nemá Disallow: / | AI vás může najít, citovat i se z vás učit |
| Být ve vyhledávání AI, ale ne v trénování | skupiny User-agent: GPTBot, User-agent: ClaudeBot a User-agent: Google-Extended, každá s Disallow: / | v ChatGPT, Claude i Perplexity zůstanete; budoucí modely se z vašich textů neučí |
| Zmizet z AI úplně | navíc Disallow: / pro OAI-SearchBot, Claude-SearchBot a PerplexityBot | AI vás nenajde ani neodkáže; uživatelské roboty to spolehlivě nezastaví |
Každá skupina začíná řádkem User-agent, pod ním následují pravidla Allow nebo Disallow. Googlebot do zákazů nepatří, jinak zmizíte i z Googlu.
Vyplatí se zablokovat GPTBot a další trénovací roboty?
Menší firmě, která prodává služby nebo zboží, a ne samotné texty, bych trénovací roboty nechal povolené. Zablokováním GPTBota z vyhledávání v ChatGPT nezmizíte, ale přestanete být ve zdroji, ze kterého se učí budoucí modely, a právě z naučených znalostí ChatGPT odpovídá, když na webu nehledá. Pro firmu, která chce, aby AI věděla, co dělá, kde a za kolik, je to špatný obchod. Jinak to vidí vydavatel, jehož produktem je text sám: zpravodajství, placené návody nebo databáze. Tam dává zákaz trénování smysl, protože model by pak odpovídal místo něj.
U Googlu pozor na častý omyl. Zákaz Google-Extended podle Googlu nemá vliv na to, jestli je web v Google Search, ani na pozice. Neodstraní vás ani z AI přehledů. Ty čtou web přes běžný Googlebot a omezují se stejnými nástroji jako úryvky ve výsledcích, tedy značkami nosnippet, max-snippet nebo noindex. Kdo zablokuje Google-Extended v domnění, že se tím schová před AI přehledy, nezmění nic. Kdo zablokuje Googlebot, zmizí z vyhledávání úplně.
Může hosting nebo Cloudflare blokovat AI roboty bez vašeho vědomí?
Může, a robots.txt o tom nic neprozradí. Firewall hostingu nebo CDN rozhoduje dřív, než se robot k souboru dostane. Cloudflare od 15. září 2026 nastavuje novým doménám výchozí pravidla: roboti zařazení jako trénovací nebo jako agenti se blokují na stránkách, které zobrazují reklamu, vyhledávací roboti zůstávají povolení. Mezi agenty Cloudflare řadí i boty, kteří stahují stránku v reálném čase pro chat, tedy typ, jako je ChatGPT-User. Nastavení najdete v Cloudflare pod Security Settings, položka Configure AI bot policies, kde má každá kategorie tři volby: blokovat všude, blokovat na stránkách s reklamou, nebo povolit.
Starší přepínač Block AI bots, který blokoval jen trénovací roboty, Cloudflare ruší. Jedna past v nových pravidlech zůstává: roboti, kteří slouží zároveň vyhledávání i trénování, se zablokují pokaždé, když zakážete trénování. Google přitom v dokumentaci k AI přehledům výslovně píše, že procházení musí povolovat robots.txt i CDN a hostingová infrastruktura.
Pokud web nespravujete sami, pošlete správci jednu otázku: blokuje hosting, CDN nebo bezpečnostní doplněk nějaké boty, a kde se to nastavuje? Odpověď „nevím“ je taky odpověď. Znamená, že to nikdo nekontroloval.
Proč ChatGPT nevidí text, který na webu vidíte vy?
Protože váš prohlížeč spouští JavaScript a většina AI robotů ne. Vercel v prosinci 2024 zveřejnil měření ze své sítě, podle kterého žádný z hlavních AI crawlerů JavaScript nevykresluje: roboti OpenAI (OAI-SearchBot, ChatGPT-User, GPTBot), ClaudeBot, PerplexityBot ani další. Soubory se skripty si sice stahují, ale nespustí je. Výjimky jsou dvě, Gemini, který využívá infrastrukturu Googlebota, a AppleBot. Když tedy server pošle prázdnou kostru stránky a text do ní doplní až skript v prohlížeči, robot ChatGPT dostane stránku bez obsahu. Vy na monitoru vidíte celý web, ChatGPT jen menu, patičku, nebo vůbec nic.
- 569 mil.
- požadavků GPTBota za měsíc v síti Vercelu; Claude 370 mil., Googlebot 4,5 mld.
- 11,5 %
- požadavků ChatGPT míří na soubory JavaScriptu, které pak nespustí
- 23,84 %
- požadavků Clauda míří na soubory JavaScriptu, které pak nespustí
Vercel, 2024
Vercel, 2024
Vercel, 2024
Zdroj: Vercel: The rise of the AI crawler (prosinec 2024), data z nextjs.org a sítě Vercelu
Řešení je vykreslovat důležitý obsah na serveru (server-side rendering), případně stránky předem vygenerovat jako hotové HTML. Vercel to formuluje prakticky: text, nadpisy a ceny patří do HTML ze serveru, kdežto počítadla zhlédnutí nebo chatovací okno klidně můžou zůstat na JavaScriptu. Obsah schovaný v záložce nebo rozbalovacím bloku nevadí, pokud je v HTML. Vadí obsah, který se stáhne až po kliknutí nebo posunutí stránky.
Jestli se to týká i vás, nepoznáte podle vzhledu webu ani podle toho, že vás najde Google. Googlebot JavaScript vykreslit umí, takže web s prázdnou kostrou může v Googlu stát dobře a ChatGPT přitom vidí prázdnou stránku. Ověříte to jedině testem níže.
Jak si sami ověřit, že váš web AI přečte?
Stačí prohlížeč a deset minut. Otevřete adresu vasweb.cz/robots.txt a zkontrolujte, že tam není Disallow: / pod hvězdičkou ani pod jménem AI robota, kterého chcete pustit. Pak na důležité stránce stiskněte Ctrl+U (na Macu Cmd+Option+U), čímž uvidíte zdrojový kód tak, jak ho poslal server, a přes Ctrl+F v něm hledejte větu z prostředku stránky. Když ji najdete, robot ji uvidí taky. Nakonec požádejte ChatGPT, ať konkrétní adresu otevře a shrne. Nepoužívejte nástroj Prozkoumat prvek, ten ukazuje stránku až po spuštění JavaScriptu a test by vám lhal.
- 01
Otevřete vasweb.cz/robots.txt
Hledejte
Disallow: /podUser-agent: *nebo pod jménem AI robota. Když soubor neexistuje, roboti smějí všude. - 02
Ctrl+U a hledání věty
Ve zdrojovém kódu najděte větu z prostředku stránky a cenu. Chybí-li, text dokresluje JavaScript a AI roboti ho nevidí.
- 03
Požádejte ChatGPT o shrnutí URL
Když stránku neotevře nebo popíše něco jiného, máte signál. Úspěch ale prověří jen ChatGPT-User, ne OAI-SearchBot.
- 04
Zeptejte se správce hostingu
Blokuje firewall, CDN nebo bezpečnostní doplněk nějaké boty? Pokud máte přístup k logům serveru, hledejte v nich OAI-SearchBot.
Třetí krok má háček, který stojí za vysvětlení. Když ChatGPT stránku shrne, víte jen, že prošel uživatelský robot, na kterého se robots.txt vztahovat nemusí. O vyhledávacím robotovi to nic neříká. Proto robots.txt a zdrojový kód kontrolujte vždy, i když test v chatu dopadne dobře. A jestli už z ChatGPT na web chodí lidé, zjistíte v Google Analytics, postup popisujeme v článku Návštěvnost z ChatGPT v GA4.
Jak vypadá web, který AI přečte: rostuconsulting.com
Náš vlastní web běží na frameworku TanStack Start, který stránky vykresluje na serveru. Když robot otevře kterýkoli článek v Magazínu, dostane od serveru hotové HTML s celým textem, titulkem stránky, kanonickou adresou i strukturovanými daty JSON-LD, která strojům říkají, kdo článek napsal a kdy. JavaScript potom jen přidá interaktivní části, třeba lištu s průběhem čtení nebo nastavení cookies, a na obsah nesahá. Můžete si to vyzkoušet hned. Stiskněte na této stránce Ctrl+U a vyhledejte tuhle větu. Najdete ji ve zdrojovém kódu přesně tak, jak ji čtete.
Náš robots.txt je krátký. Má skupiny pro Googlebot, Bingbot, Twitterbot a facebookexternalhit, skupinu pro všechny ostatní pod hvězdičkou, u všech Allow: /, a odkaz na sitemapu. Žádného AI robota nejmenuje a nic nezakazuje, takže GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot i Google-Extended smějí dovnitř, včetně trénování. Je to přesně ta volba, kterou doporučujeme firmám, které prodávají práci, a ne texty. Chceme, aby AI věděla, co děláme a za kolik, a ceny máme na webu jako maximum, třeba AI audit do 12 500 Kč. Robots.txt ovšem nic neříká o vrstvě hostingu, tu je potřeba ověřit zvlášť.
Technickou část webu u nás má na starosti CTO Martin Pražienka, takže věci jako vykreslování na serveru, kanonické adresy nebo sitemap s datem poslední skutečné změny obsahu řešíme přímo v kódu, ne doplňkem navrch.
Kolik stojí kontrola, jestli web vidí ChatGPT?
Základní kontrolu z předchozího postupu zvládnete sami a zdarma. Když v ní něco nesedí, třeba text ve zdrojovém kódu chybí nebo nevíte, co dělá hosting, máte tři cesty. Hodinová AI konzultace stojí 1 490 Kč za 60 minut a hodí se, když potřebujete projít jeden konkrétní problém. Technický SEO audit stojí do 10 000 Kč, prověří indexaci, strukturu a technické bariéry webu a výstup je zadání pro vývojáře. AI audit webu do 12 500 Kč k tomu přidá, jestli a v jakém kontextu se vaše značka objevuje v odpovědích AI a z jakých zdrojů AI o vás čerpá.
Cenu znáte předem jako maximum, ne až z faktury za odpracované hodiny. Jsme menší tým, takže mluvíte přímo s lidmi, kteří audit dělají, ne s obchodníkem, který vaše otázky přeposílá dál. Pro první orientaci si můžete projít i dvanáctibodovou kontrolu AI viditelnosti.
Časté otázky
Když zablokuji GPTBot, zmizím z ChatGPT?
Z vyhledávání v ChatGPT ne. GPTBot sbírá obsah pro trénování modelů, do vyhledávání v ChatGPT vybírá weby OAI-SearchBot a OpenAI uvádí, že každé nastavení platí samostatně. Zákaz GPTBota jen říká, že váš obsah se nemá používat k trénování budoucích modelů.
Respektuje ChatGPT-User soubor robots.txt?
Ne spolehlivě. OpenAI píše, že ChatGPT-User navštěvuje stránky na žádost konkrétního uživatele, a proto se na něj pravidla robots.txt vztahovat nemusí. Perplexity-User podle Perplexity robots.txt obvykle ignoruje. Anthropic naopak uvádí, že jeho roboti robots.txt respektují. Spolehlivě uživatelské roboty zastaví jen pravidla na úrovni hostingu nebo CDN.
Ovlivní zákaz Google-Extended moje pozice v Googlu nebo AI přehledy?
Ne. Google-Extended podle Googlu nemá vliv na zařazení v Google Search ani na pozice a určuje jen, jestli se obsah použije pro trénování a grounding modelů Gemini. AI přehledy čtou web přes běžný Googlebot a omezit je jde značkami nosnippet, max-snippet nebo noindex.
Jak dlouho trvá, než se změna v robots.txt projeví?
OpenAI uvádí, že jeho systémy se změně v robots.txt přizpůsobí zhruba do 24 hodin, Perplexity píše o nejvýš 24 hodinách. Změny v nastavení firewallu nebo CDN se podle Perplexity můžou šířit déle.
Potřebuji kvůli ChatGPT soubor llms.txt?
Pro přístup robotů ne. OpenAI i Anthropic popisují jako nástroj pro řízení svých robotů robots.txt a Google u AI přehledů a AI Mode výslovně píše, že žádné zvláštní textové soubory pro AI ani speciální značkování nepotřebujete. Rozhoduje, jestli roboty pustí robots.txt a hosting a jestli je text v HTML ze serveru.
Shrnutí
Co si z toho odnést
- ChatGPT váš web uvidí, jen když OAI-SearchBot nemá zákaz v robots.txt, hosting nebo CDN ho neblokuje a text stránky je v HTML ze serveru.
- GPTBot slouží trénování, OAI-SearchBot vyhledávání v ChatGPT; nastavení jsou nezávislá, zákaz GPTBota vás z vyhledávání nevyřadí.
- Cloudflare od 15. září 2026 novým doménám blokuje trénovací a agentní boty na stránkách s reklamou; nastavení je v Security Settings, Configure AI bot policies.
- Test bez vývojáře: vasweb.cz/robots.txt, Ctrl+U a hledání věty ze stránky, pak shrnutí URL v ChatGPT. Nástroj Prozkoumat prvek k tomu nepoužívejte.
O autorovi a odborném zázemí
Kdo za článkem stojí a jak vznikl
Autor · rešerše · zpracování
Zakladatel Rostu. Několik let navrhuje weby a e-shopy, vede SEO a Google Ads a propojuje je s analytikou pro firmy i menší projekty. Vystudoval marketing na Cornell University (Ivy League), drží specializaci SEO z UC Davis a certifikaci Google Analytics.
LinkedInOdborné zázemí Rostu
Menší tým, větší péče o každý projekt
Jsme menší tým, a právě proto si na každém projektu dáváme záležet: komunikujete přímo s lidmi, kteří práci dělají, ne s account manažerem velké agentury. Jsme levnější než velké komerční firmy a naše práce je často na vyšší úrovni — měřeno výsledky, ne prezentacemi. Články vycházejí z projektů, které sami vedeme — od nového webu pro zprostředkovatele luxusních světel Di LUCE přes e-shop Oleje.Pro po SEO a obsah německé lázeňské cestovky TOPKUR.
Projekty, na kterých pracujemeJak jsme ověřovali data: Popis jednotlivých AI robotů a jejich vztahu k robots.txt jsme převzali z oficiálních stránek OpenAI, Anthropicu, Perplexity a Google Search Central, nastavení Cloudflare z jeho vývojářské dokumentace a pravidla souboru robots.txt ze standardu RFC 9309 (vše ověřeno v říjnu 2026). Údaje o JavaScriptu pocházejí z měření Vercelu zveřejněného v prosinci 2024 na datech z jeho sítě; chování robotů se od té doby mohlo změnit a měření se netýká všech AI služeb. Popis webu rostuconsulting.com vychází z jeho zdrojového kódu a souboru robots.txt. Firmy názvy robotů i nastavení mění, proto u každého kroku vysvětlujeme i princip.
Zdroje
- 01OpenAI: Overview of OpenAI Crawlers — GPTBot, OAI-SearchBot, ChatGPT-User a OAI-AdsBot; nezávislá nastavení, cca 24 hodin na změnu robots.txt, ChatGPT-User nemusí respektovat robots.txt
- 02Claude Help Center: Does Anthropic crawl data from the web, and how can site owners block the crawler? — ClaudeBot, Claude-User a Claude-SearchBot, co znamená jejich zákaz, respektování robots.txt
- 03Perplexity: Perplexity Crawlers — PerplexityBot slouží výsledkům, ne trénování; Perplexity-User robots.txt obvykle ignoruje; změny do 24 hodin
- 04Google Search Central: List of Google's common crawlers — Google-Extended: trénování a grounding Gemini, bez vlastního user-agenta, bez vlivu na Google Search
- 05Google Search Central: AI features and your website — AI přehledy a AI Mode: indexace, povolené procházení v robots.txt i v CDN, žádné zvláštní soubory pro AI
- 06Cloudflare Docs: Block AI bots / Configure AI bot policies — kategorie Search, Agent a Training; výchozí nastavení pro nové domény od 15. 9. 2026; rušení starého přepínače
- 07Vercel: The rise of the AI crawler — měření z prosince 2024: hlavní AI crawlery nespouštějí JavaScript, výjimkou Gemini a AppleBot; objemy požadavků
- 08RFC 9309: Robots Exclusion Protocol — umístění /robots.txt v kořeni, výběr skupiny pravidel, robots.txt není forma autorizace přístupu
Publikováno 26. října 2026, naposledy aktualizováno 29. října 2026. Článek vyjadřuje odbornou zkušenost autora; konkrétní situaci vašeho webu nebo e-shopu vždy posuzujeme podle jeho dat a zadání.
Proč Rostu
Menší tým, který vám pomůže dosáhnout skutečných pokroků a zisků
- Menší tým, větší péče
- Neděláme desítky projektů najednou. Každému věnujeme čas, který potřebuje, a za výsledek ručí konkrétní člověk, ne oddělení.
- Přímá komunikace
- Mluvíte s tím, kdo web, kampaně nebo analýzu skutečně dělá. Žádný account manažer mezi vámi a prací, rychlé odpovědi, žádné překládání požadavků.
- Levnější než velká agentura
- Neplatíte režii, obchodní oddělení ani kancelář v centru. Přesto je naše práce často na vyšší úrovni než od velkých komerčních firem — a cenu znáte před zahájením.
- Skutečný pokrok a zisk
- Nezajímá nás počet výstupů, ale co přinesou: víc poptávek, vyšší tržby, nižší náklady na zákazníka. Měříme to a vysvětlíme vám, co čísla znamenají.